
Ngày 22/9, Anthropic ra mắt Claude Opus 5.5 và gọi đây là mô hình mạnh nhất hãng từng thử nghiệm. Opus 5.5 đã có mặt trên ứng dụng Claude bản web và di động, qua API với mã claude-opus-5-5, cũng như trên Amazon Web Services, Google Cloud và Microsoft Azure.
Điểm lạ nằm ở vị trí của Opus 5.5 trong dòng sản phẩm. Theo Anthropic, mô hình mới làm được hầu hết công việc ở mức ngang Claude Fable 5.1, mô hình cao cấp nhất dành cho người dùng phổ thông mà hãng vừa ra mắt đầu tháng 9. Trong khi đó, chi phí vận hành của Opus 5.5 thấp hơn Opus 5 khoảng 40% với các tác vụ thông thường, và tốc độ tạo phản hồi nhanh hơn Opus 5 trên 30%.
Giá API chưa bằng một nửa Fable 5.1
Opus 5.5 có giá 4 USD (khoảng 105.000 đồng) cho mỗi một triệu token đầu vào và 20 USD (khoảng 524.000 đồng) cho mỗi một triệu token đầu ra. Opus 5 trước đó có giá lần lượt 5 USD và 25 USD. Token là đơn vị nhỏ mà mô hình dùng để đọc và viết văn bản, nên đây là con số chính quyết định hóa đơn của doanh nghiệp và lập trình viên.
Với Fable 5.1, mức giá là 10 USD (khoảng 262.000 đồng) cho đầu vào và 50 USD (khoảng 1,31 triệu đồng) cho đầu ra. Theo VentureBeat, giá token cơ bản của Opus 5.5 rẻ hơn Fable 5.1 khoảng 60%.
Bộ nhớ đệm (tính năng giúp mô hình không phải xử lý lại phần nội dung lặp đi lặp lại) cũng giảm giá. Mỗi một triệu token đọc từ bộ nhớ đệm có giá 0,2 USD (khoảng 5.200 đồng), giảm 60% so với Opus 5. Người cần phản hồi nhanh hơn có thể chọn chế độ Fast với giá gấp đôi, 8 USD đầu vào và 40 USD đầu ra (khoảng 210.000 và 1,05 triệu đồng).
Vượt Fable 5.1 ở mảng lập trình
Anthropic công bố Opus 5.5 đạt 66,4% trên Terminal-Bench 4.0, bài kiểm tra khả năng tự thao tác dòng lệnh để hoàn thành công việc. Fable 5.1 đạt 55,8%, Opus 5 đạt 52,3%. Trên CursorBench 4.0, Opus 5.5 đạt 57,8% so với 51,8% của Fable 5.1. Ở FrontierCode v1.1, khoảng cách hẹp hơn, 54,4% so với 50,3%.
Với công việc văn phòng, mô hình mới đạt 1.846 điểm Elo trên GDPval-AA v2.1, cao hơn Fable 5.1 (1.735) và Opus 5 (1.708). Ở các bài kiểm tra khả năng điều khiển máy tính như OSWorld 2.0 hay đọc biểu đồ Chartography, cách biệt chỉ còn khoảng một điểm phần trăm.
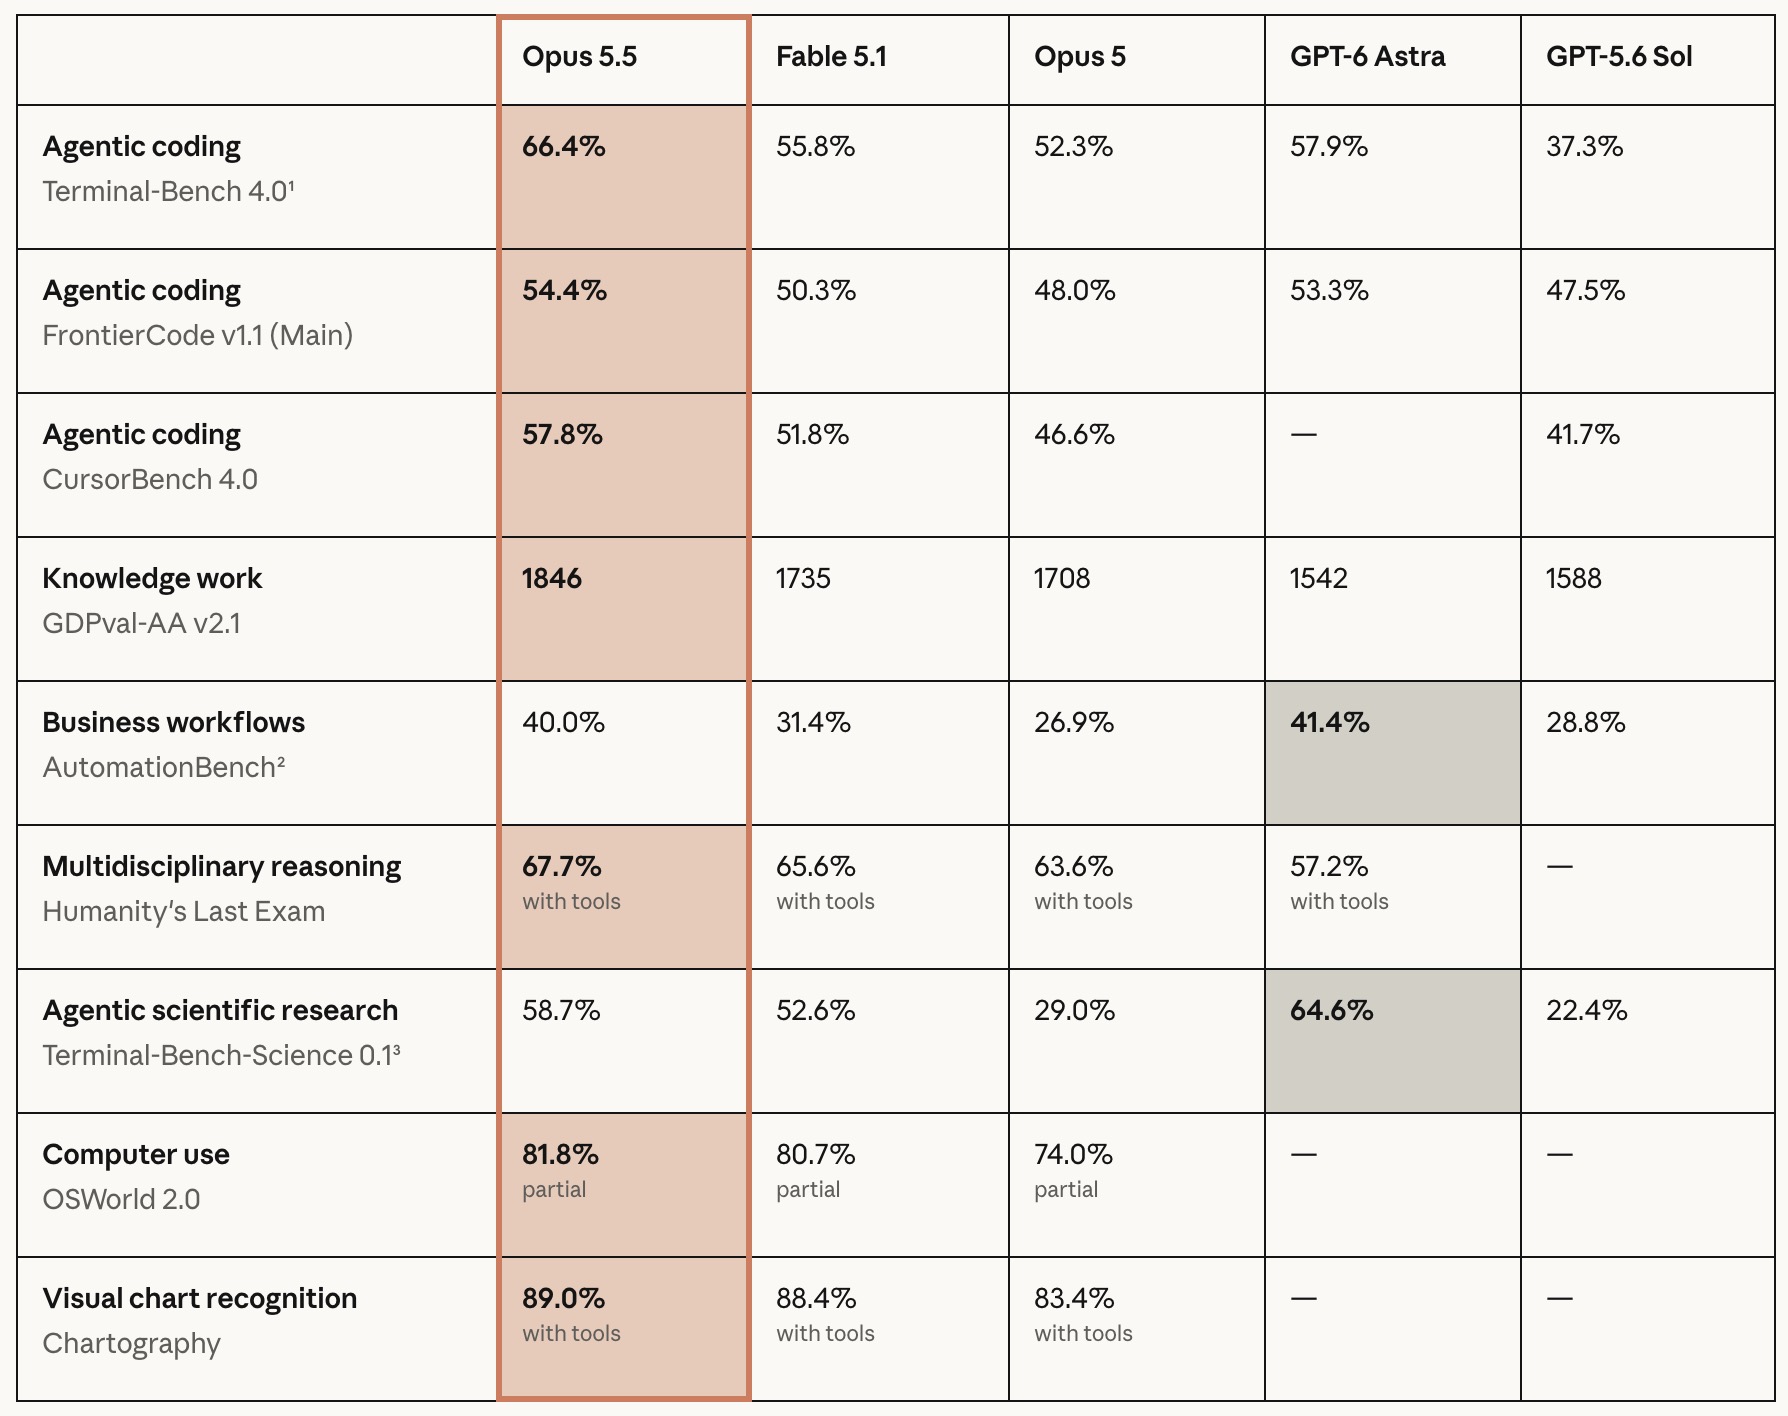
Bảng điểm benchmark so sánh Opus 5.5, Fable 5.1 và Opus 5 cũng như các đối thủ tới từ OpenAI
Anthropic cũng đưa ra vài ví dụ từ thử nghiệm nội bộ. Trong một tác vụ chuyển mã nguồn từ ngôn ngữ C sang Rust, Opus 5.5 hoàn thành sau 9,5 giờ với chi phí thấp hơn 51%, trong khi Fable 5.1 mất 12 giờ. Một tác vụ rà soát mã nguồn khác, Opus 5 cần hơn 20 giờ, Opus 5.5 làm xong trong chưa tới 3 giờ.
So với đối thủ, OfficeChai tổng hợp rằng Opus 5.5 dẫn trước GPT-6 Astra của OpenAI ở phần lớn bài kiểm tra, như Terminal-Bench 4.0 (66,4% so với 57,9%) hay Humanity's Last Exam khi được dùng công cụ (67,7% so với 57,2%). GPT-6 Astra vẫn thắng ở AutomationBench, bài kiểm tra tự động hóa quy trình doanh nghiệp, và Terminal-Bench-Science (64,6% so với 58,7%).
Chính Anthropic cũng lưu ý rằng ở mức này, chênh lệch điểm benchmark không còn phản ánh chính xác năng lực, và khoảng cách thực tế giữa Opus 5.5 với Fable 5.1 "hẹp hơn những gì điểm số cho thấy".
Code gọn hơn, nhưng lỗi trên mỗi dòng tăng
Một đánh giá độc lập của Sonar, công ty chuyên về chất lượng mã nguồn, cho thấy bức tranh nhiều chiều hơn. Trên 544 tác vụ lập trình có kiểm thử, Opus 5.5 đạt tỷ lệ vượt qua 87,68%, gần như ngang Opus 5 (88,6%). Mô hình mới viết ít hơn 27,5% số dòng code và dùng ít hơn 40% token đầu ra, tổng số vấn đề phát hiện giảm 42%.
Tuy vậy, mật độ lỗi lại tăng 12%, lên 644 lỗi trên mỗi triệu dòng code. Nhóm lỗi xử lý đồng thời (khi nhiều luồng chạy song song và tranh nhau tài nguyên, loại lỗi khó tái hiện và khó sửa) tăng 44%, trở thành nhóm lỗi lớn nhất. Ở chiều ngược lại, lỗ hổng bảo mật mức nghiêm trọng nhất giảm 53%. Nói cách khác, Opus 5.5 viết ít và gọn hơn, nhưng lập trình viên vẫn cần kiểm tra kỹ, nhất là với code chạy đa luồng.
Yêu cầu nhạy cảm có thể bị chuyển sang mô hình cũ
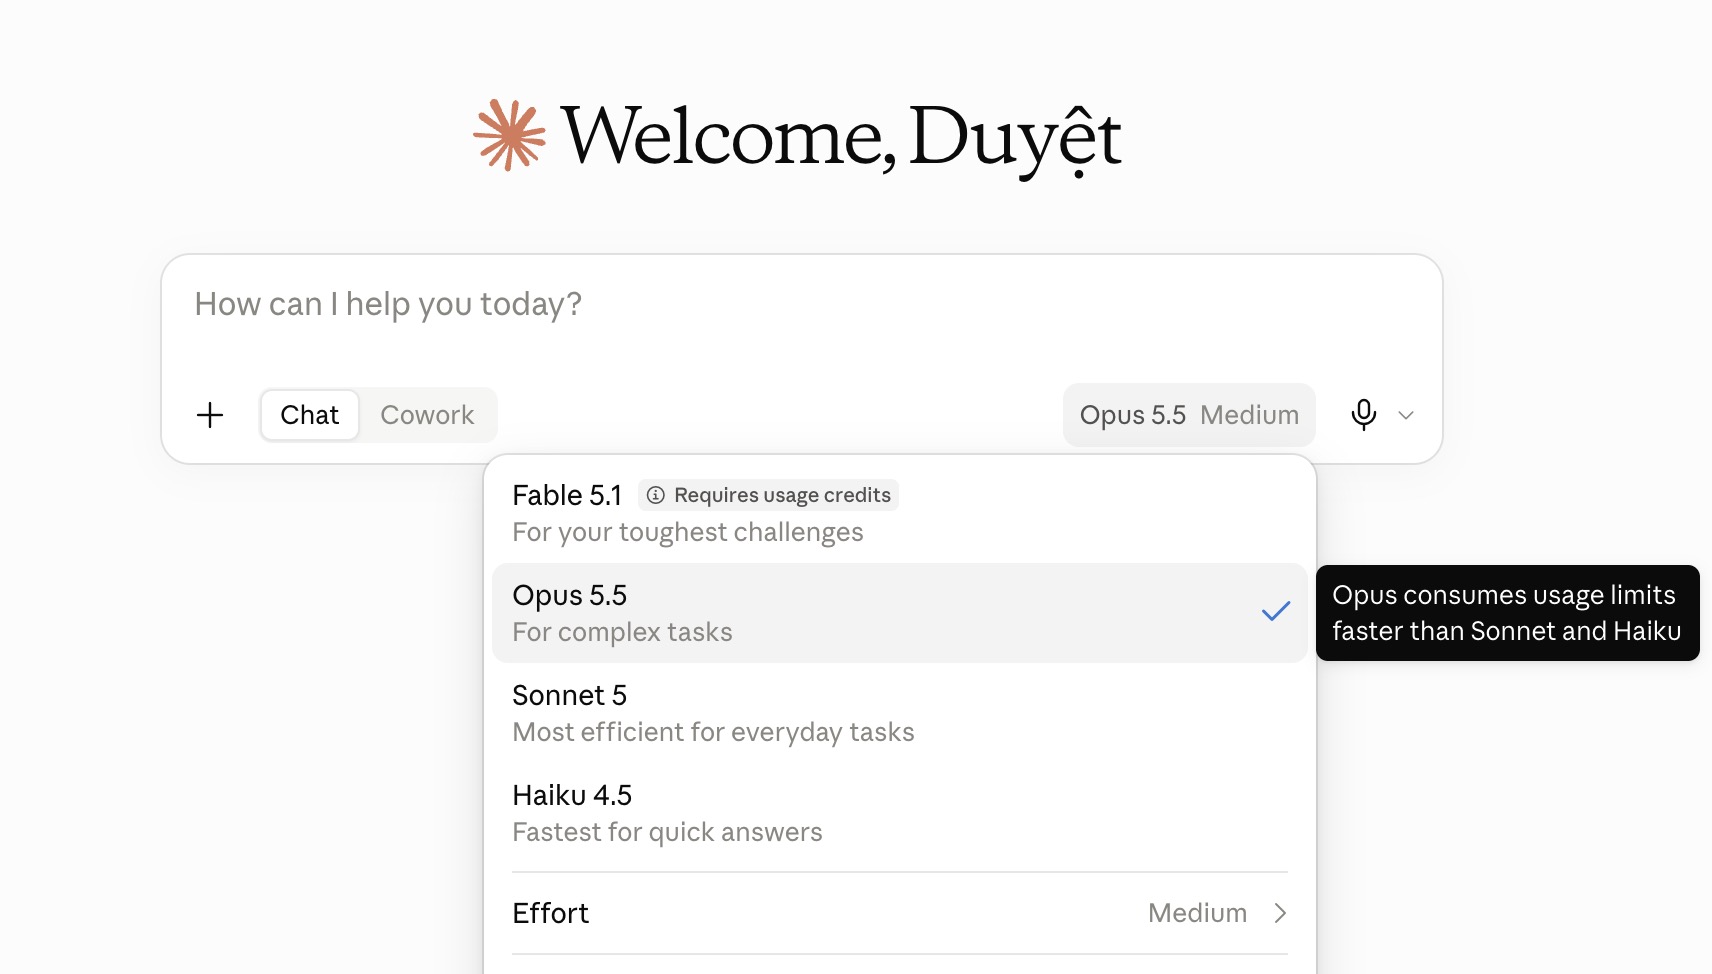
Vì năng lực trong lĩnh vực sinh học và an ninh mạng ngang Fable 5.1, Opus 5.5 dùng bộ cơ chế bảo vệ tương tự. Một số yêu cầu về an ninh mạng sẽ được chuyển sang xử lý bằng Opus 4.8. The New Stack cảnh báo việc này có thể khiến các hệ thống AI tự động nhiều bước nhận kết quả từ những mô hình có năng lực khác nhau mà không hay biết. Các nhà nghiên cứu bảo mật và khoa học sự sống đủ điều kiện có thể đăng ký chương trình xác minh riêng để được nới hạn chế.
Với lập trình viên, Opus 5.5 kèm vài thay đổi phải sửa code. Chế độ suy luận (thinking) luôn bật và không thể tắt. Việc ép mô hình gọi một công cụ cụ thể có thể báo lỗi. Những ứng dụng hiển thị đoạn văn bản giữa các lần gọi công cụ làm thông báo tiến độ cũng cần điều chỉnh.
Người dùng trả phí được nới giới hạn
Cùng với Opus 5.5, Anthropic nâng giới hạn sử dụng theo chu kỳ 5 giờ cho các gói Pro, Max, Team và Enterprise tính theo số người dùng. Người đăng ký cũng được tặng một lượt đặt lại giới hạn, dùng được bất kỳ lúc nào đến hết ngày 22/10.
Anthropic cho biết Claude Sonnet 5.5 và Haiku 5.5 sẽ ra mắt trong vài tuần tới.
Thế Duyệt